


本文按原论文章节结构用中文转述其内容,保留全部公式、参数表、数据表、图片与 63 条参考文献,但不是逐句直译。图片裁自原论文 PDF,版权归 American Physical Society 所有。原文出处:N. Artrith and J. Behler, Phys. Rev. B 85, 045439 (2012),DOI: 10.1103/PhysRevB.85.045439。
摘要
金属表面处的原子环境与体相差别很大,尤其当"真实表面"发生重构或存在缺陷时,会出现极其复杂的原子构型,这给开发适合大规模分子动力学模拟的精确原子间势带来了显著挑战。近年来人工神经网络(NN)成为为困难体系构建势能面的一种有前景的新方法。本工作以铜为基准体系探讨高维 NN 势对金属表面的适用性;对体相铜及大量表面结构性质的详细分析表明,NN 势能以极小的计算代价给出几乎达到 DFT 品质的结果。
引言
金属表面上的化学过程贯穿多相催化、腐蚀、有机分子自组装单层和电化学等领域。这些过程往往涉及性质迥异的多个子系统,化学键从共价、离子、金属键一直跨到弱的非键相互作用,因此很难发展一种能统一描述所有相互作用的高效势函数。过去几十年针对各类子系统已有不少专门的势:描述共价分子的经典力场 \cite{allinger1989mm3,cornell1995amber,rappe1992uff,brooks1983charmm}、基于键级的势(如半导体的 Tersoff 势 \cite{tersoff1986,tersoff1988})、金属的嵌入原子法 \cite{daw1984eam,daw1993eam,baskes1992meam},但能够无偏地、同等地同时描述所有这些体系的势仍然十分缺乏。
作者从势能面(PES)的角度切入。PES 是原子坐标的高维函数,给出势能及其导数(原子受力)。传统做法基于物理考量设计带少量参数的近似函数形式,再拟合电子结构能量或实验性质。参数少固然有吸引力,也是保持正确物理行为的必要条件,但正因为组成项不够灵活,定量精度必然受限。
另一条路线是纯数学拟合。这类势在数值上可以很精确,且对金属键、共价键、离子键一视同仁;可选方案包括适合低维 PES 的样条 \cite{press2007nr,deboor2001splines}、遗传规划 \cite{makarov1998gp}、插值移动最小二乘(IMLS)\cite{maisuradze2003imls,guo2004imls}、修正 Shepard 插值(MSI)\cite{ischtwan1994msi,jordan1995msi} 以及高斯近似势 \cite{bartok2010gap}。它们的函数形式都很一般,因此需要谨慎的拟合过程和对所得 PES 形状的细致检查。
人工神经网络 \cite{bishop1995nn,haykin2009nn} 是另一类适合构建 PES 的灵活函数。NN 起源于对大脑信号处理的研究(第一个人工神经元早在 1943 年就已提出 \cite{mcculloch1943}),后来发展为一大类模式识别和数据分类算法 \cite{bishop1995nn}。关键在于,多个研究组已经证明前馈型 NN 原则上能以任意精度逼近任何实值多维函数 \cite{hornik1989,cybenko1989},这正是把 NN 用于原子间势的理论基础。
NN 势的核心假设是原子坐标与势能之间存在唯一的函数关系,这对所有可用 Born–Oppenheimer 近似描述的体系都成立。电子结构计算原则上能给出任意构型的能量,但代价高昂,只能算出 PES 上一组代表性的点;分子动力学(MD)却要求对任意构型都能得到能量和力。NN 恰好能把离散的参考点平滑地连成连续的高维 PES,而且求值比 DFT 快好几个数量级。
NN 势此前已用于从低维分子到高维体相材料的各种体系 \cite{behler2011pccp,handley2010,behler2010chemmodel},但对固体表面的适用性尚未被探索。文献中研究气体–表面动力学的低维 NN PES 都把表面原子隐含处理:假定无缺陷单晶、表面原子固定在理想体相位置,PES 的有效维度只有吸附分子的自由度。
本文采用 Behler 与 Parrinello 提出的高维 NN 方法 \cite{behler2007prl},显式包含体系中所有原子的所有自由度,以铜为基准体系考察体相以及大量带缺陷表面结构的结构与能量性质能否被准确描述。文章的逻辑是:先确认体相铜(它决定平板模型的晶格常数,而现实表面模型也必须包含类体相环境的深层原子),再考察带缺陷与不带缺陷的表面(真实表面上常见空位、吸附原子、台阶和扭折,经验势对此往往力不从心),最后用一个 DFT 无法直接处理的大型表面模型证明 NN 势对超大体系依然可靠。
神经网络势
前馈神经网络
NN 势的核心组件是前馈神经网络(图 1)。网络由若干层组成,每层含若干神经元(节点)。输出层节点给出能量 $E$;原子位置以坐标向量 $\mathbf{G} = {G_i}$ 的形式送入输入层。图 1 有三个输入节点,对应一个三维 PES。输入与输出层之间是一个或多个隐藏层,其节点没有物理意义,但决定了函数形式:隐藏层越多、节点越多,NN 越灵活。
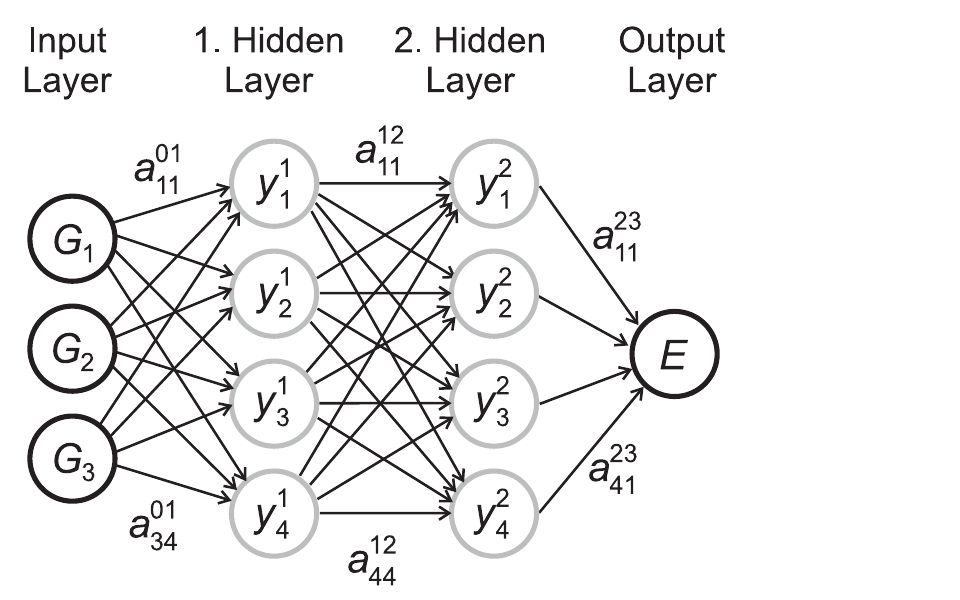
图 1:一个三维前馈神经网络(NN)的例子,含两个隐藏层,每层四个神经元。其解析形式(式 (2))在能量 E 与描述体系的三个坐标 G_i 之间建立函数关系;连接神经元的箭头表示拟合参数(权重),偏置权重未画出。
相邻层的节点由权重参数相连,这些权重就是 NN 的拟合参数,箭头方向表明信息从输入层经隐藏层单向流向输出层。层数和每层节点数定义了 NN 的架构,通常用简写记号表示——图 1 是一个 3-4-4-1 NN。
权重分两类:连接权重 $a_{ij}^{kl}$ 连接第 $k$ 层节点 $i$ 与第 $l = k+1$ 层节点 $j$(输入层上标为 0);偏置权重 $b_i^j$ 把第 $j$ 层的节点 $i$ 与一个偏置节点相连。计算从输入层开始:在第一个隐藏层的每个节点上先对输入做以连接权重为系数的线性组合,再施加一个非线性激活函数 $f_i^j$(常用 sigmoid 或双曲正切)。激活函数赋予 NN 超越线性组合的拟合能力,偏置权重则把激活函数的非线性区域平移到合适位置。第一个隐藏层节点 $i$ 的输出为
$$ y_i^1 = f_i^1 \left( b_i^1 + \sum_{j=1}^{3} a_{ji}^{01} G_j \right). \tag{1} $$
这些值再乘以权重传给第二个隐藏层、累加、施加激活函数,最后在输出节点合并。输出节点使用线性激活函数,以免限制能量值的范围。图 1 示例 NN 的完整函数形式为
$$ E = f_1^3 \left( b_1^3 + \sum_{l=1}^{4} a_{l1}^{23} , f_l^2 \left( b_l^2 + \sum_{k=1}^{4} a_{kl}^{12} , f_k^1 \left( b_k^1 + \sum_{j=1}^{3} a_{jk}^{01} G_j \right) \right) \right). \tag{2} $$
权重通过迭代拟合确定,即最小化一组已知能量(通常来自电子结构计算)的均方根误差(RMSE)。另外保留一组已知能量作为独立测试集,它不参与优化权重,只用于估计 PES 对训练集之外结构的品质。
标准前馈网络的局限
这类 NN 可直接用于小分子的低维 PES \cite{gassner1998,no1997,prudente1998cpl,raff2005,malshe2009,manzhos2006jpca,manzhos2007},也成功用于小分子在金属表面的吸附 \cite{blank1995,lorenz2004,carbogno2010,carbogno2008,lorenz2006,behler2005prl,behler2007jcp,ludwig2007,latino2008}——但后者必须采用冻结表面近似,只显式考虑分子自由度。
用单个前馈 NN 表示体系总能量在体系变复杂时有三个根本限制:
- 为保持效率,NN 规模尤其是输入节点数不能任意增加。
- 势一旦建好,体系大小就不能变:添加原子时没有对应的权重,移除原子时对应输入节点的值没有定义。
- 必须处理对称性:输入节点的顺序并非任意,交换两个化学等价原子就会改变输入向量 $\mathbf{G}$ 和 NN 能量。可以通过对称化坐标 \cite{gassner1998,lorenz2004,behler2007jcp} 或对称神经元 \cite{prudente1998jcp} 引入对称性,但对大体系构造合适坐标十分困难。
另一种思路是用一组各自依赖坐标子集的 NN 构建较大分子的 PES \cite{malshe2009,manzhos2007,manzhos2006jcp}。这类方法很精确,还能通过高阶项系统改进,但 NN 数目随体系大小迅速增长,计算上比标准 NN 势更昂贵。因此需要另辟蹊径才能处理数千原子的体系。十多年前的首次尝试是用 NN 表示 Tersoff 势中的多体项 \cite{hobday1999msmse,hobday1999nimb},这一仍严重依赖经验函数形式的方法后来通过引入尺寸可变的 NN 发展为纯粹的高维 NN 势 \cite{bholoa2006,sanville2008}。
Behler–Parrinello 高维方案
本文采用 Behler–Parrinello 方案 \cite{behler2007prl}:$N$ 原子体系的总能量是各原子能量贡献之和,
$$ E = \sum_{i=1}^{N} E_i \left[ \mathbf{G}_i({\mathbf{R}_k}) \right]. \tag{3} $$
原子能量取决于化学环境,由 $M_i$ 个对称函数值组成的向量 $\mathbf{G}_i = {G_i^m}$ 描述。对称函数是多体函数,依赖局部环境中所有原子的笛卡尔坐标 $\mathbf{R}_k$。局部环境由截断函数定义:
$$ f_c(R_{ij}) = \begin{cases} 0.5 \left[ \cos\left( \dfrac{\pi R_{ij}}{R_c} \right) + 1 \right] & R_{ij} \leqslant R_c, \\ 0 & R_{ij} > R_c. \end{cases} \tag{4} $$
本工作取截断半径 $R_c = 6$ Å,$f_c$ 在截断处的值和斜率都为零。按文献 \cite{behler2011jcp} 的记号,径向对称函数为
$$ G_i^{2,m} = \sum_{j \neq i} e^{-\eta (R_{ij} - R_s)^2} f_c(R_{ij}). \tag{5} $$
这里用 $R_{ij}$ 的高斯函数而非距离本身,以体现原子 $j$ 对原子 $i$ 能量的影响随距离衰减;再乘以截断函数保证在 $R_c$ 处值和斜率为零。把所有近邻的贡献相加得到单个数值,可以视作一种配位数——这一点至关重要:对称函数的数目必须固定(它们就是原子 NN 的输入节点),而截断球内的近邻数在 MD 中会变化。用一组不同 $\eta$ 的 $G^2$ 就能分辨近邻的径向分布;$R_s$ 可把高斯中心从原子 $i$ 移开形成球壳,本工作取零。
角向对称函数为
$$ G_i^{4,m} = 2^{1-\zeta} \sum_{j,k \neq i} \left( 1 + \lambda \cos\theta_{ijk} \right)^{\zeta} e^{-\eta \left( R_{ij}^2 + R_{ik}^2 + R_{jk}^2 \right)} f_c(R_{ij}) , f_c(R_{ik}) , f_c(R_{jk}), \tag{6} $$
其中 $\theta_{ijk} = \arccos\left( \dfrac{\mathbf{R}_{ij} \cdot \mathbf{R}_{ik}}{R_{ij} R_{ik}} \right)$ 以原子 $i$ 为顶点。$\lambda = \pm 1$ 决定余弦极大值位于 $0^\circ$ 还是 $180^\circ$,$\zeta$ 控制角分辨率,$\eta$ 决定角向函数的有效径向范围。
每个原子的对称函数值向量是其化学环境的"结构指纹"。纯金属这类单组分体系通常需要 40 到 60 个函数,本工作用了 51 个,参数列于表 I(进一步讨论见文献 \cite{behler2011jcp})。
表 I:描述局部原子环境的对称函数参数(对应式 (5)、(6) 的定义)。
$G^2$ 型对称函数
| 编号 | $\eta$ (Bohr$^{-2}$) | $R_{\text{shift}}$ (Bohr) | $R_c$ (Bohr) |
|---|---|---|---|
| 1 | 0.001 | 0.000 | 11.338 |
| 2 | 0.010 | 0.000 | 11.338 |
| 3 | 0.020 | 0.000 | 11.338 |
| 4 | 0.035 | 0.000 | 11.338 |
| 5 | 0.060 | 0.000 | 11.338 |
| 6 | 0.100 | 0.000 | 11.338 |
| 7 | 0.200 | 0.000 | 11.338 |
| 8 | 0.400 | 0.000 | 11.338 |
角向对称函数(原文表头记为 $G^3$,对应正文式 (6))
| 编号 | $\eta$ (Bohr$^{-2}$) | $\lambda$ | $\zeta$ | $R_c$ (Bohr) |
|---|---|---|---|---|
| 9 | 0.0001 | −1.000 | 1.000 | 11.338 |
| 10 | 0.0001 | 1.000 | 1.000 | 11.338 |
| 11 | 0.0001 | −1.000 | 2.000 | 11.338 |
| 12 | 0.0001 | 1.000 | 2.000 | 11.338 |
| 13 | 0.0030 | −1.000 | 1.000 | 11.338 |
| 14 | 0.0030 | 1.000 | 1.000 | 11.338 |
| 15 | 0.0030 | −1.000 | 2.000 | 11.338 |
| 16 | 0.0030 | 1.000 | 2.000 | 11.338 |
| 17 | 0.0080 | −1.000 | 1.000 | 11.338 |
| 18 | 0.0080 | 1.000 | 1.000 | 11.338 |
| 19 | 0.0080 | −1.000 | 2.000 | 11.338 |
| 20 | 0.0080 | 1.000 | 2.000 | 11.338 |
| 21 | 0.0150 | −1.000 | 1.000 | 11.338 |
| 22 | 0.0150 | 1.000 | 1.000 | 11.338 |
| 23 | 0.0150 | −1.000 | 2.000 | 11.338 |
| 24 | 0.0150 | 1.000 | 2.000 | 11.338 |
| 25 | 0.0150 | −1.000 | 4.000 | 11.338 |
| 26 | 0.0150 | 1.000 | 4.000 | 11.338 |
| 27 | 0.0150 | −1.000 | 16.000 | 11.338 |
| 28 | 0.0150 | 1.000 | 16.000 | 11.338 |
| 29 | 0.0250 | −1.000 | 1.000 | 11.338 |
| 30 | 0.0250 | 1.000 | 1.000 | 11.338 |
| 31 | 0.0250 | −1.000 | 2.000 | 11.338 |
| 32 | 0.0250 | 1.000 | 2.000 | 11.338 |
| 33 | 0.0250 | −1.000 | 4.000 | 11.338 |
| 34 | 0.0250 | 1.000 | 4.000 | 11.338 |
| 35 | 0.0250 | −1.000 | 16.000 | 11.338 |
| 36 | 0.0250 | 1.000 | 16.000 | 11.338 |
| 37 | 0.0450 | −1.000 | 1.000 | 11.338 |
| 38 | 0.0450 | 1.000 | 1.000 | 11.338 |
| 39 | 0.0450 | −1.000 | 2.000 | 11.338 |
| 40 | 0.0450 | 1.000 | 2.000 | 11.338 |
| 41 | 0.0450 | −1.000 | 4.000 | 11.338 |
| 42 | 0.0450 | 1.000 | 4.000 | 11.338 |
| 43 | 0.0450 | −1.000 | 16.000 | 11.338 |
| 44 | 0.0450 | 1.000 | 16.000 | 11.338 |
| 45 | 0.0800 | −1.000 | 1.000 | 11.338 |
| 46 | 0.0800 | 1.000 | 1.000 | 11.338 |
| 47 | 0.0800 | −1.000 | 2.000 | 11.338 |
| 48 | 0.0800 | 1.000 | 2.000 | 11.338 |
| 49 | 0.0800 | −1.000 | 4.000 | 11.338 |
| 50 | 0.0800 | 1.000 | 4.000 | 11.338 |
| 51 | 0.0800 | 1.000 | 16.000 | 11.338 |
每个原子的对称函数向量送入一个原子 NN,输出原子能量 $E_i$。每个原子一个 NN,且所有原子 NN 共享同一组权重,于是原子次序变得任意——交换两个同种原子只是改变 $E_i$ 的求和顺序。
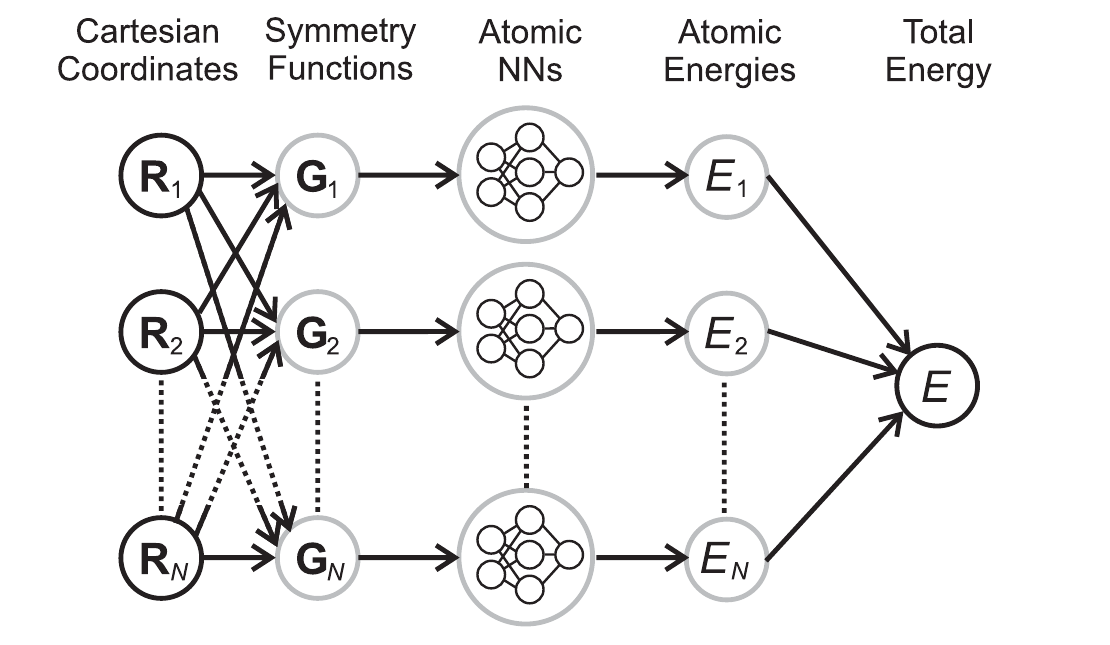
图 2:N 原子体系的高维神经网络势结构。输出为总能量 E,是各原子能量 E_i 之和;每个 E_i 是一个原子前馈 NN(参见图 1)的输出,其输入是描述原子 i 局部化学环境的对称函数向量 G_i。如箭头所示,G_i 既依赖原子自身坐标 R_i,也依赖所有近邻原子的坐标。
整个方案如图 2 所示:先由所有原子的笛卡尔坐标 $\mathbf{R}_i$ 算出各原子的对称函数 $\mathbf{G}_i$(对称函数依赖环境中的所有原子,其函数形式 \cite{behler2011jcp} 保证了平移和旋转不变性),再求和得到总能量;由于解析形式已知,也能算出解析力。这样的 PES 可用于原子数不同的体系:加原子就加一个原子 NN,减原子就删一个。此类 HDNNP 已成功用于硅 \cite{behler2008prl,behler2008pssb}、钠 \cite{eshet2010}、碳 \cite{khaliullin2010,khaliullin2011},并在加入静电项后用于氧化锌 \cite{artrith2011zno}。本文的目标是以铜为基准探索其对固体表面的适用性。
计算细节
参考 DFT 计算
参考计算使用全电子程序 FHI-aims \cite{blum2009fhiaims},Kohn–Sham 轨道展开在以原子为中心的数值原子轨道基组上——基函数在计算开始时通过求解自由原子的 Kohn–Sham 方程确定。基组为 FHI-aims 的"tier 1"(最小基组加上由修改核电荷的类氢轨道导出的附加函数),每个原子共 40 个基函数。所有周期性结构使用稠密 k 点网格,密度约相当于四原子常规 fcc 晶胞的 $12 \times 12 \times 12$。总能量收敛到约每原子 1 meV,力收敛到约 10 meV/Å。交换关联采用 PBE 泛函 \cite{perdew1996pbe},相对论效应通过标度 ZORA \cite{vanlenthe1994zora} 计入。局域基函数使得周期性(体相、平板)和非周期性(团簇)体系可以一致地计算。每个 $N$ 原子结构的 DFT 计算为拟合提供 $3N + 1$ 条信息:一个总能量和 $3N$ 个力分量。
神经网络势的构建
势用作者自己的程序 RuNNer \cite{behler_runner} 构建,训练集通过系统的迭代过程确定。文献中在 PES 重要区域逐步添加数据点的方案既有经验势领域的 \cite{ischtwan1994msi,dawes2008},也有 NN 领域的 \cite{raff2005}。沿此思路,作者先对理想和热扰动的晶体结构、团簇、平板做 DFT 计算,构建一个品质一般的初步势,用它做 MD 和几何优化提出新结构(合理与否皆可),再用 DFT 重算并加入训练集。如此交替拟合与生成结构,势就能自洽地改进,直到 RMSE 收敛且不再出现错误特征。
这种做法的缺点是,即使对势已经描述得很好的结构也要做很多 DFT 计算。作者利用 NN 的高灵活性反其道而行之——这种灵活性在预测远离训练点的结构时本是一个严重问题,却可以变成优点:
- 对同一训练集,用不同架构构建若干拟合,保证函数形式不同。
- 挑出 RMSE 大致相同的几个拟合——单凭 RMSE 分不出优劣,但它们必然彼此不同。
- 用其中一个拟合(例如通过 MD)生成大量构型,再用其他拟合重算能量并比较。
- 若所有拟合对某结构预测相近的能量,说明它很可能靠近训练集中的某个点(所有 NN 都被训练成能复现该点);若各拟合预测差异很大,说明该结构远离训练集,此时才做 DFT 计算并加入训练集。
这样就可以系统地搜索大量结构而不做不必要的昂贵 DFT 计算。图 3 是两个拟合沿一条轨迹的能量比较:多数构型两者非常接近,NN 势可视为可靠;三个灰色区域中两者差异很大,应取代表性结构用 DFT 计算并加入训练集。
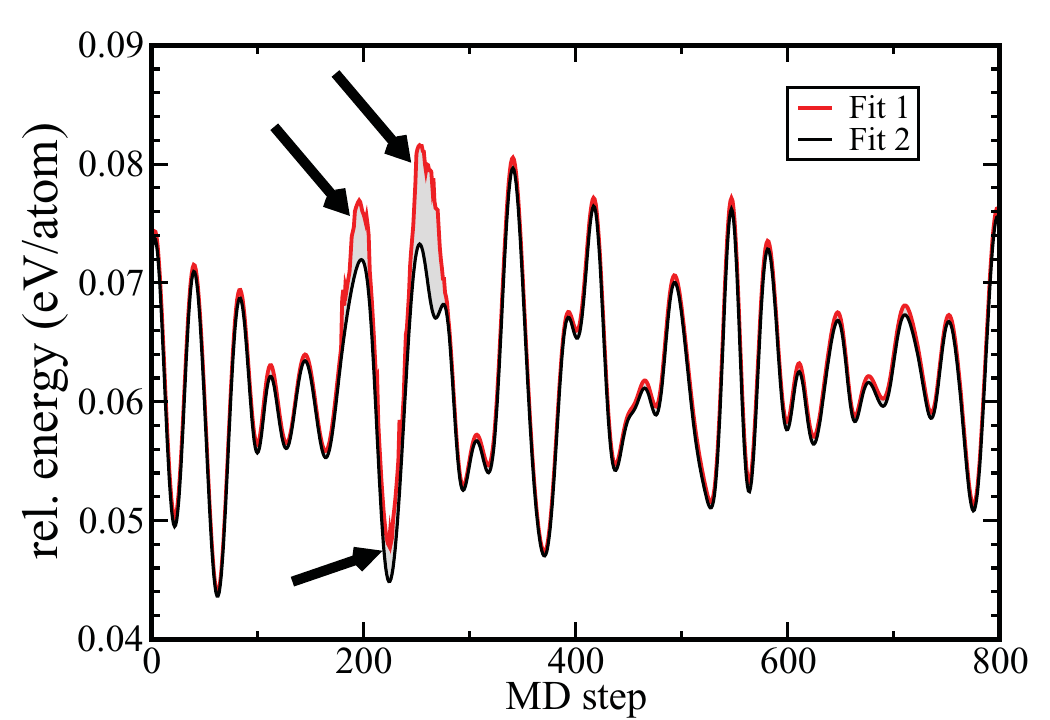
图 3:用同一训练集构建的两个不同 NN 势沿一条轨迹给出的能量比较。多数构型两者非常接近,表明这些结构与训练集相似;灰色区域两者差异很大,这类结构位于训练集缺失的构型空间区域,应加入训练集。
最终 DFT 数据集含 15 448 个体相结构、13 896 个平板和 8 419 个原子数至多 100 的团簇(组成细节见补充材料 \cite{artrith2012sm}),共 617 475 个原子环境、1 890 188 条信息。结构被随机分成训练集(33 963 个)和独立测试集(3 800 个)。
神经网络架构
架构与权重同样影响精度。NN 太小则无法表示 PES 的细微特征;太大则灵活性过高,可能过拟合——训练结构表示得很好,训练点之间的构型却精度骤降。两种情况都能通过监测训练集和测试集的 RMSE 发现:拟合初期两者都下降;若两者相近但仍很高,应增大 NN;若训练集 RMSE 低而测试集 RMSE 高得多,则是过拟合。原则上应使用能达到所需精度且训练与测试误差相近的最小 NN,实践中最高效的办法是经验性地构建一批不同架构的 NN PES,选泛化性能(测试集误差)最好的那个。
作者还指出,确定权重是一个含数千参数的高维优化问题,不可能找到全局极小;但通常能找到足以良好表示所有物理性质的局部极小。对同一架构存在许多局部极小,最终结果依赖权重初值、训练点顺序和优化算法等初始设置。
结果
神经网络势
作者用不同的初始随机权重和架构构建了一批势,最佳拟合为 51-30-30-1 架构(两个隐藏层用双曲正切激活,输出节点线性),含 2521 个权重参数。训练集和测试集的能量 RMSE 分别为每原子 3.6 和 3.9 meV,力 RMSE 分别为 42.8 和 42.0 meV/Bohr。平均绝对误差(MAE)通常比 RMSE 小得多(后者受离群点影响大):能量 MAE 分别为每原子 2.09 和 2.22 meV,力 MAE 分别为 29.3 和 29.4 meV/Bohr。训练与测试误差差别极小,说明基本没有过拟合。
即使更小的 51-10-10-1 NN 也能给出相当低的误差:训练集与测试集能量 RMSE 分别为每原子 4.87 和 4.59 meV,力 RMSE 分别为 40.3 和 41.5 meV/Bohr。图 4 比较了四种架构前 20 次迭代的训练集能量 RMSE——超过 51-30-30-1 之后误差降低已微乎其微,因此选定该架构做进一步考察。
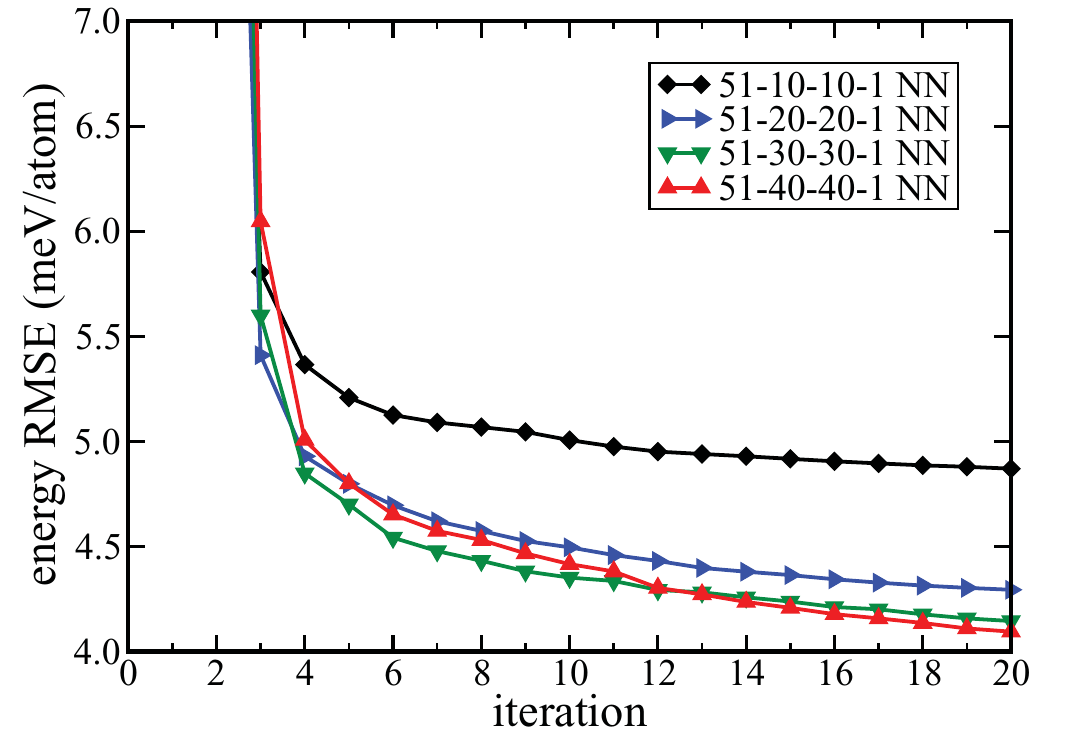
图 4:几种 NN 架构的训练集拟合误差比较。
图 5 把训练集和测试集的 NN 能量画成 DFT 能量的函数,所有点都非常靠近对应完美拟合的 $45^\circ$ 直线。图 6 的误差分布显示多数点的误差小于每原子 2 meV;训练集最大能量误差为每原子 52 meV,测试集为每原子 39 meV,都对应能量极高、MD 中通常不会访问的结构——只有温度高于约 5000 K 时才会变得重要。
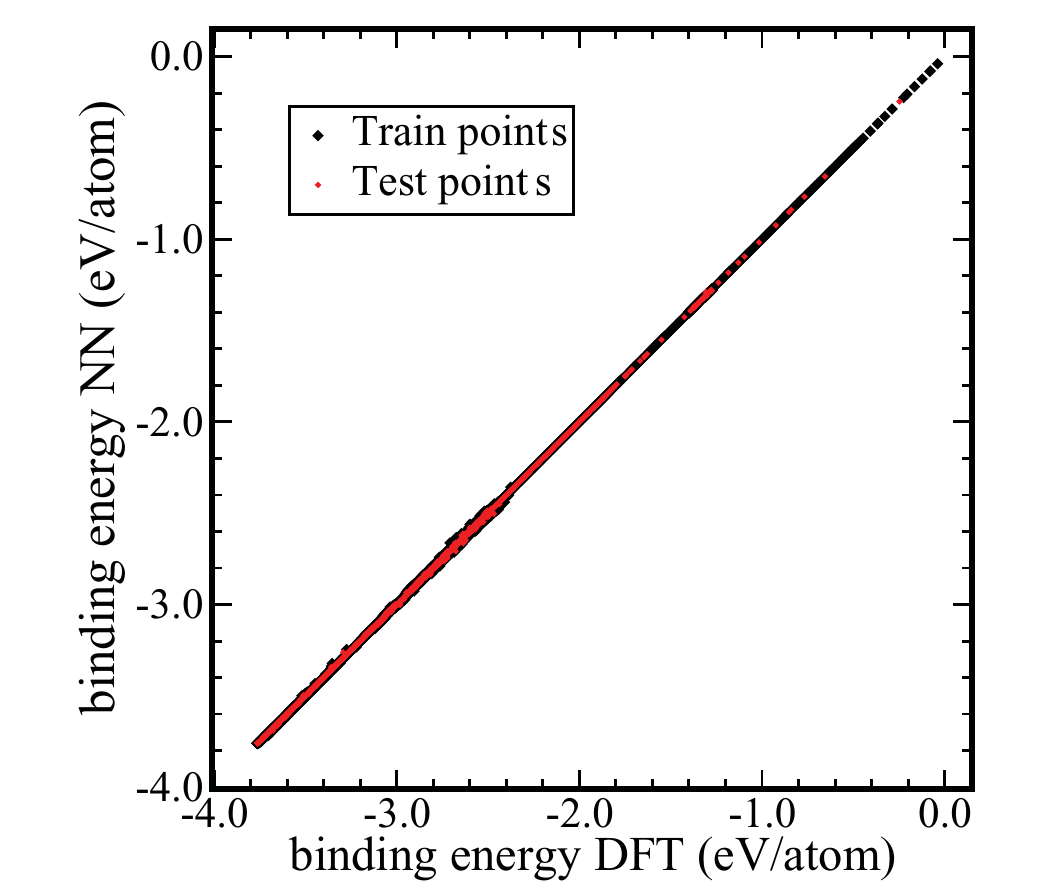
图 5:训练集和测试集中各结构的 DFT 能量与 NN 能量比较,所有点都非常靠近斜率 45° 的直线。图中给出的是扣除自由原子能量后的结合能。
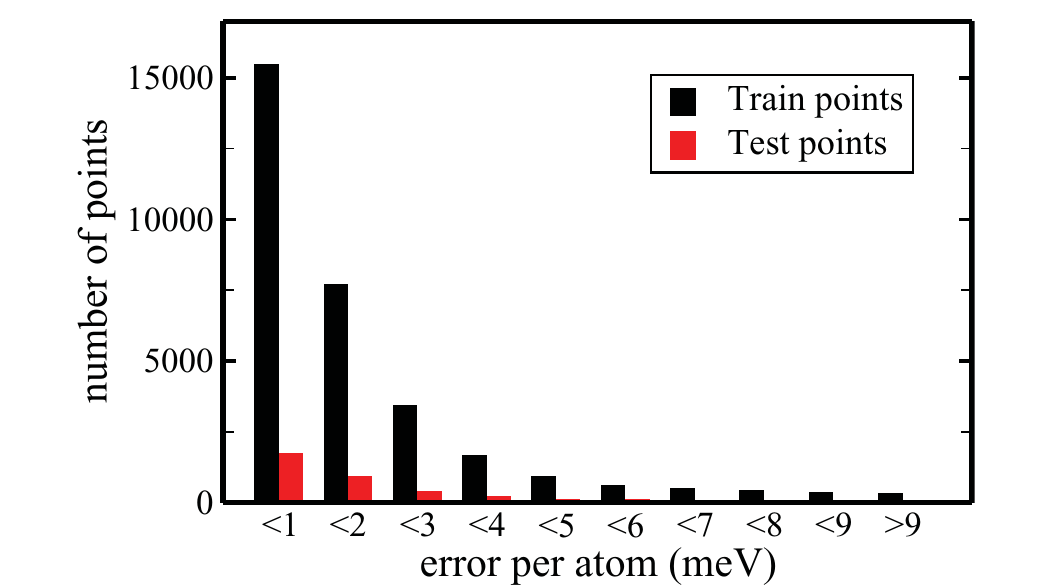
图 6:训练集(33 963 个结构)和测试集(3 800 个结构)中拟合误差的分布。
体相铜
可靠描述体相铜是把势用于表面的前提。最重要的能量量是内聚能
$$ E_{\text{coh}} = \frac{1}{N} \left( E_{\text{bulk}} - N E_{\text{atom}} \right), \tag{7} $$
其中 $N$ 是晶胞原子数,$E_{\text{atom}}$ 是电子基态自由铜原子的能量——它是 DFT 确定的常数,无需 NN 拟合。表 II 汇总了不同晶体结构的内聚能、平衡晶格常数和体模量 $B$。
表 II:铜各种晶体结构的晶格参数、内聚能和体模量(GPa),NN 与 DFT 的比较。
| 结构 | $E_{\text{coh}}$/eV (DFT) | $E_{\text{coh}}$/eV (NN) | 晶格参数 (DFT) | 晶格参数 (NN) | 体模量 (DFT) | 体模量 (NN) |
|---|---|---|---|---|---|---|
| fcc | 3.763 | 3.756 | $a = 3.630$ Å | $a = 3.630$ Å | 140 | 138 |
| bcc | 3.719 | 3.716 | $a = 2.885$ Å | $a = 2.887$ Å | 137 | 135 |
| sc | 3.281 | 3.282 | $a = 2.407$ Å | $a = 2.407$ Å | 103 | 108 |
| hcp | 3.740 | 3.740 | $a = 4.862$ Å, $c/a = 1.627$ | $a = 4.856$ Å, $c/a = 1.631$ | – | – |
与实验一致,fcc 是最稳定的结构。NN 给出的 fcc 晶格常数 3.630 Å 与 DFT 相同(实验值 3.615 Å \cite{lide2009crc}),体模量 138 GPa 对 DFT 的 140 GPa。fcc 铜的弹性常数:NN 给出 $c_{11} = 177$ GPa(DFT:173)、$c_{12} = 119$ GPa(DFT:123)、$c_{44} = 83$ GPa(DFT:80)。其他晶体结构的吻合同样极佳。
随后考察不同晶体结构、不同空位浓度(由超胞尺寸决定)下的空位形成能:
$$ E_{\text{vac,bulk}} = E_{\text{bulk,v}}(N-1) - \frac{N-1}{N} E_{\text{bulk}}(N), \tag{8} $$
$E_{\text{bulk}}(N)$ 为无缺陷晶胞能量,$E_{\text{bulk,v}}(N-1)$ 为含空位体系能量。为分辨空位附近原子弛豫的影响,作者分两种情形计算:移除原子后不弛豫("未弛豫"),以及移除后用各自方法独立弛豫(DFT 结构由 DFT 力优化,NN 结构由 NN 势优化)。所有情形下晶格常数固定为理想值,只优化原子位置。
表 III:体相铜不同晶体结构中的空位形成能(eV)。"弛豫"数据由各自方法优化结构得到。
| 结构 | 超胞 | 未弛豫 $E^{\text{DFT}}_{\text{vac,bulk}}$ | 未弛豫 $E^{\text{NN}}_{\text{vac,bulk}}$ | 弛豫 $E^{\text{DFT}}_{\text{vac,bulk}}$ | 弛豫 $E^{\text{NN}}_{\text{vac,bulk}}$ |
|---|---|---|---|---|---|
| fcc | (2 × 2 × 2) | 1.196 | 1.195 | 1.164 | 1.174 |
| (3 × 3 × 3) | 1.147 | 1.250 | 1.108 | 1.214 | |
| bcc | (2 × 2 × 2) | 1.069 | 1.021 | 0.982 | 0.958 |
| (3 × 3 × 3) | 1.070 | 1.084 | 0.925 | 0.944 | |
| hcp | (2 × 2 × 2) | 1.030 | 1.064 | 1.022 | 1.045 |
| (3 × 3 × 3) | 1.128 | 1.046 | 1.103 | 1.026 |
体相空位形成能得到合理复现,平均绝对偏差约 45 meV。误差相对较大的原因是含空位的结构在训练集中代表性不足——生成大部分训练点的 MD 模拟中不会自发形成空位。考虑到超胞很大(fcc 的 (2 × 2 × 2) 和 (3 × 3 × 3) 分别含 32 和 108 个原子),每原子误差其实小得多;而且误差集中在空位附近化学环境代表性不足的原子上——两种超胞的误差平均相同、不随体系大小增长即可证明。向训练集加入更多含空位的结构可望改善。
为考察无序结构,作者用 NN 势对各种晶体结构在很宽温度范围做 MD,再挑代表性结构用 DFT 重算。图 7 是从 500 K bcc 铜轨迹中随机抽取的 16 原子畸变结构的能量比较,典型偏差只有每原子几个 meV;图 8 比较了其中一个结构的原子受力,同样吻合极好。
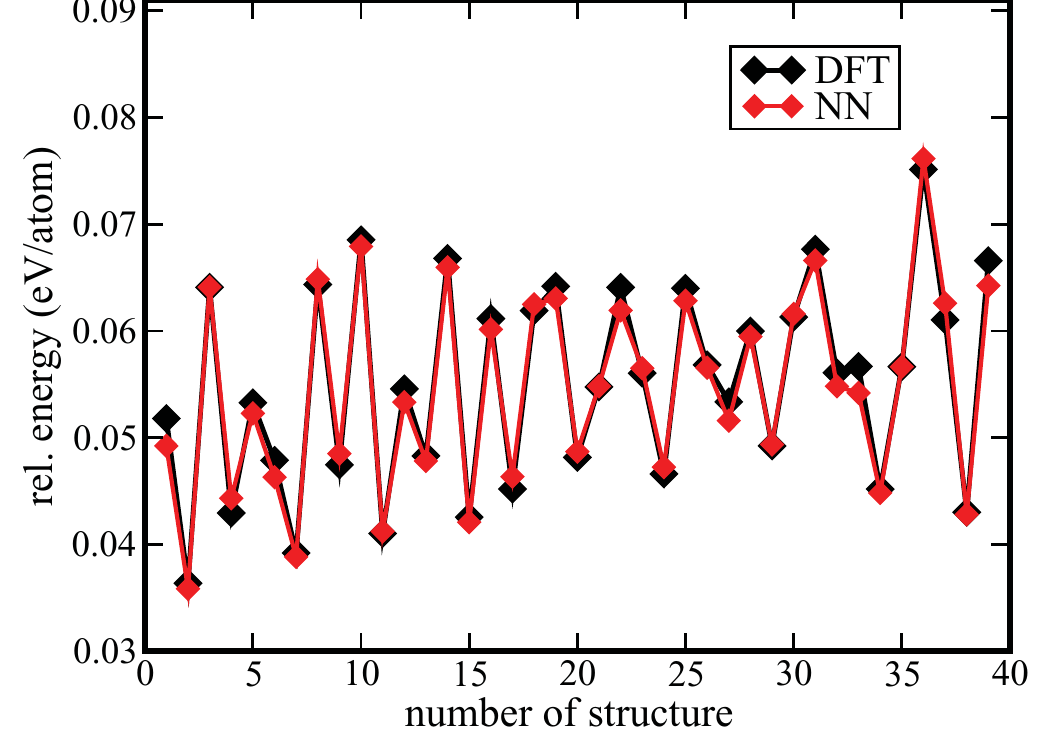
图 7:从 500 K bcc 铜分子动力学轨迹中选出的若干 16 原子体相结构的 DFT 与 NN 能量比较。
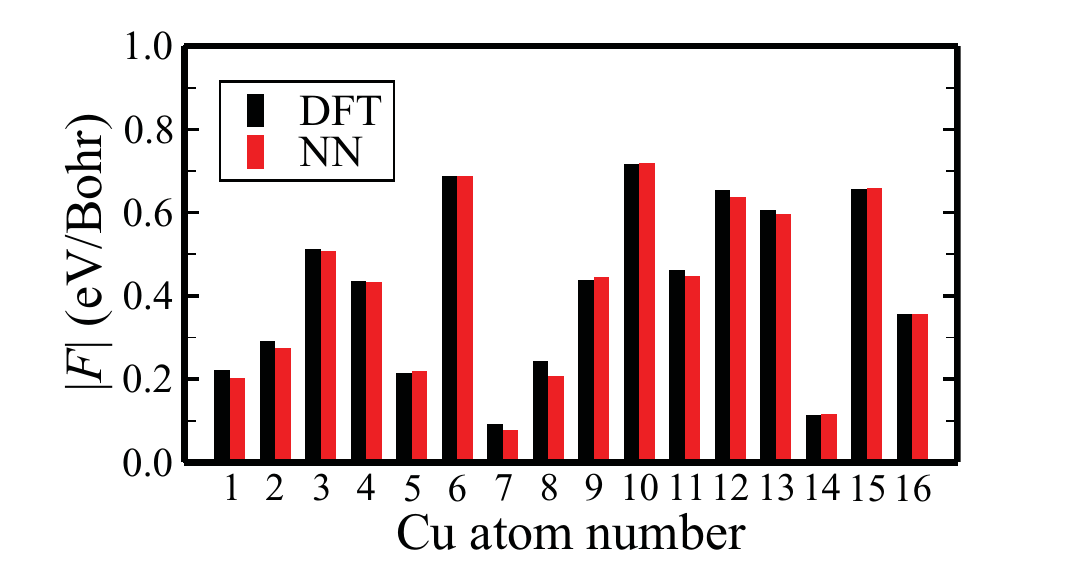
图 8:16 原子体相结构中各铜原子所受 DFT 与 NN 力的比较,构型随机取自 500 K bcc 铜的 MD 轨迹。
铜表面
理想低指数表面
表面最基本的性质是表面能——劈开体相形成表面所需的能量:
$$ \gamma = \frac{1}{2A} \left( E_{\text{slab}} - N E_{\text{bulk}} \right), \tag{9} $$
$E_{\text{slab}}$ 为 $N$ 原子平板的能量,$E_{\text{bulk}}$ 为体相中一个原子的能量,$A$ 为表面积,因子 2 对应平板的两个表面。表 IV 比较了多种表面的表面能,体相截断平板和完全弛豫平板都算了。作者特别提醒:DFT 中平板与体相的布里渊区不同,必须保证 k 点高度收敛;NN 由于训练数据本身就来自收敛的 k 点网格,其能量在构造上就对应稠密网格。
表 IV:不同铜表面的 DFT 与 NN 表面能 $\gamma$(meV/Å$^2$)。平板模型使用八层金属层;fcc(110)mr 为 Cu(110) 的缺列重构。
| 表面 | 未弛豫 $\gamma_{\text{DFT}}$ | 未弛豫 $\gamma_{\text{NN}}$ | 弛豫 $\gamma_{\text{DFT}}$ | 弛豫 $\gamma_{\text{NN}}$ |
|---|---|---|---|---|
| fcc(111) | 93.601 | 92.867 | 93.159 | 92.743 |
| fcc(100) | 101.251 | 101.767 | 100.532 | 100.995 |
| fcc(110) | 105.146 | 106.158 | 102.387 | 103.921 |
| fcc(110)mr | 113.364 | 114.484 | 109.927 | 111.689 |
| bcc(111) | 104.765 | 103.013 | 101.458 | 99.551 |
| bcc(100) | 97.742 | 95.309 | 96.972 | 94.602 |
| bcc(110) | 86.519 | 87.973 | 86.364 | 87.438 |
| sc(111) | 77.397 | 78.969 | 77.318 | 78.723 |
| sc(100) | 59.282 | 60.250 | 59.263 | 60.064 |
| sc(110) | 74.173 | 75.895 | 73.842 | 75.658 |
无论截断还是弛豫表面,DFT 与 NN 都高度一致:所有晶体结构和低指数表面的能量排序相同,平均绝对误差仅 1.34 meV/Å$^2$;与 DFT 一致,(111) 是 fcc 铜最稳定的表面。弛豫后的结构性质也吻合:fcc Cu(111) 第一层在 DFT 中向内弛豫约 0.023 Å(体相层间距的 1.083%),NN 为 0.021 Å(0.995%)。
表面空位
表面空位形成能定义为从表面移除一个原子所需的能量:
$$ E_{\text{vac,surf}} = E_{\text{slab,vac}} + E_{\text{atom}} - E_{\text{slab}}, \tag{10} $$
$E_{\text{slab,vac}}$ 与 $E_{\text{slab}}$ 分别为含空位与无缺陷表面超胞的能量。作者同样对未弛豫和弛豫表面都做了计算(表 V)。平均误差约 85 meV,且与超胞尺寸无关;弛豫与未弛豫结构表示得同样好,DFT 与 NN 优化的结构也非常相似。
表 V:以八层平板表示的不同铜表面上的空位形成能(eV)。"弛豫"数据由各自方法优化结构得到。
| 表面 | 超胞 | 未弛豫 $E^{\text{DFT}}_{\text{vac,surf}}$ | 未弛豫 $E^{\text{NN}}_{\text{vac,surf}}$ | 弛豫 $E^{\text{DFT}}_{\text{vac,surf}}$ | 弛豫 $E^{\text{NN}}_{\text{vac,surf}}$ |
|---|---|---|---|---|---|
| fcc(111) | (2 × 1) | 4.252 | 4.346 | 4.193 | 4.284 |
| (2 × 2) | 4.413 | 4.596 | 4.367 | 4.550 | |
| (3 × 3) | 4.482 | 4.607 | 4.439 | 4.562 | |
| fcc(100) | (2 × 1) | 4.023 | 4.123 | 3.977 | 4.075 |
| (2 × 2) | 4.195 | 4.255 | 4.143 | 4.209 | |
| (3 × 3) | 4.224 | 4.332 | 4.189 | 4.287 | |
| fcc(110) | (2 × 1) | 4.069 | 4.073 | 4.043 | 4.052 |
| (2 × 2) | 4.076 | 4.062 | 4.046 | 4.053 | |
| (3 × 3) | 4.110 | 4.112 | 4.078 | 4.097 | |
| bcc(111) | (2 × 1) | 3.729 | 3.783 | 3.437 | 3.335 |
| (2 × 2) | 3.695 | 3.831 | 3.433 | 3.504 | |
| (3 × 3) | 3.653 | 3.835 | 3.386 | 3.515 | |
| bcc(100) | (2 × 1) | 3.858 | 3.988 | 3.755 | 3.862 |
| (2 × 2) | 3.982 | 4.122 | 3.867 | 3.981 | |
| (3 × 3) | 4.033 | 4.166 | 3.803 | 3.932 | |
| bcc(110) | (2 × 1) | 4.496 | 4.465 | 4.256 | 4.230 |
| (2 × 2) | 4.440 | 4.461 | 4.118 | 4.159 | |
| (3 × 3) | 4.442 | 4.456 | – | 4.119 |
表面势
吸附或在表面扩散的额外铜原子所感受的势,是理解重构、生长和吸附等表面原子重排过程的关键。作者计算了一个铜原子在 Cu(111) 和 Cu(100) 上方 1.85 Å 处沿高对称路径的势能(图 9)。DFT 与 NN 的偏差只有几个 meV,正是 NN 势 RMSE 的典型量级;其他离表面距离也得到相近品质。在 (2 × 2) 超胞的 Cu(111) 上,最稳定吸附位是 fcc 位:结合能 DFT 为 2.903 eV,NN 为 2.890 eV;相对第一金属层的最优高度 DFT 为 1.75 Å,NN 为 1.79 Å。
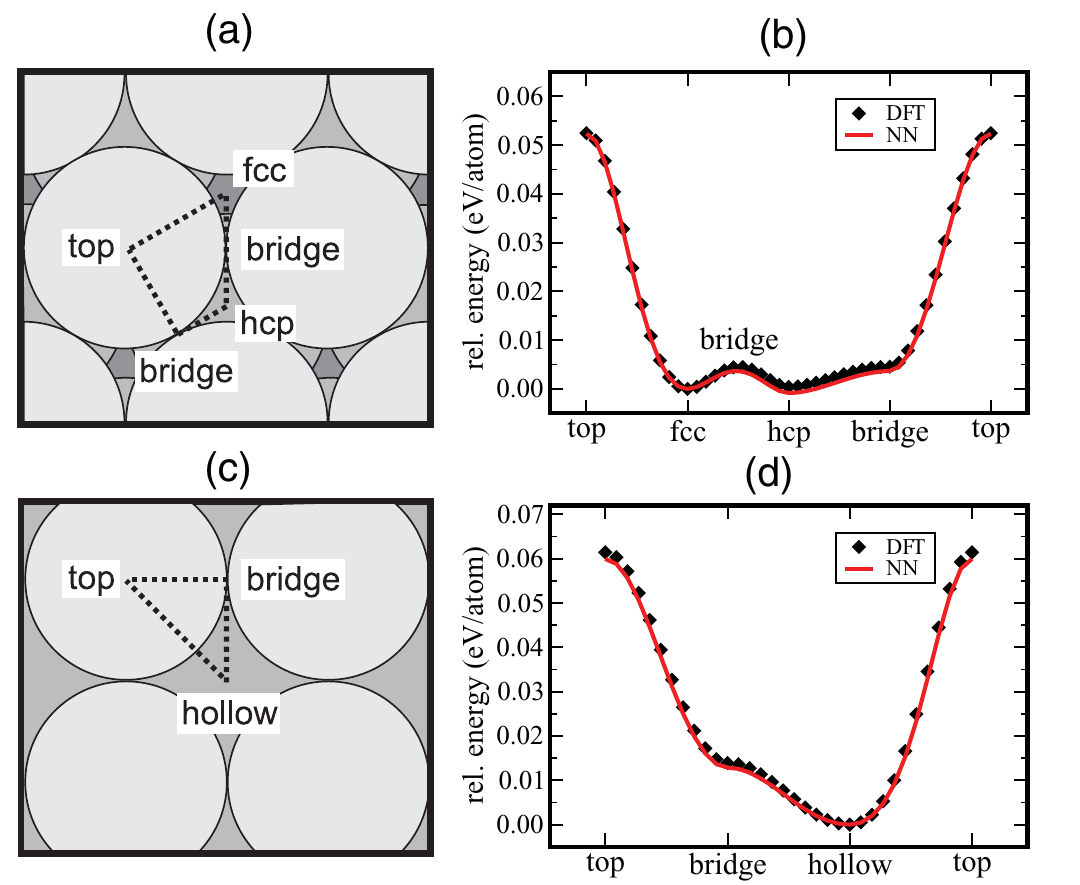
图 9:一个铜原子在洁净 Cu (2 × 2) 表面上方 1.85 Å 处移动时的 DFT 与 NN 能量曲线。(a) 为 (111) 表面上的路径,能量曲线见 (b);(c) 为 (100) 表面上的路径,能量曲线见 (d)。
讨论
对大体系的适用性
NN 势的原子能量只依赖截断半径内的局部环境,因此可以用小体系的 DFT 数据训练,却能用于数千原子的大体系。问题是:对 DFT 无法直接处理的体系,如何检验和改进精度?
作者构造了一个含空位、吸附原子、扭折和台阶的"真实"Cu(111) 表面模型(图 10),共 29 443 个原子。既然无法对整个体系比较 NN 与 DFT,就必须缩小体系并使用只依赖局部环境的物理量:选出十二个代表性原子,以对称函数截断半径为界截取以它们为中心的团簇(图 11)。DFT 中不存在唯一定义的"原子能量",所以团簇的 NN 原子能量无法与 DFT 比较,但作用在中心原子上的力可以直接比较。
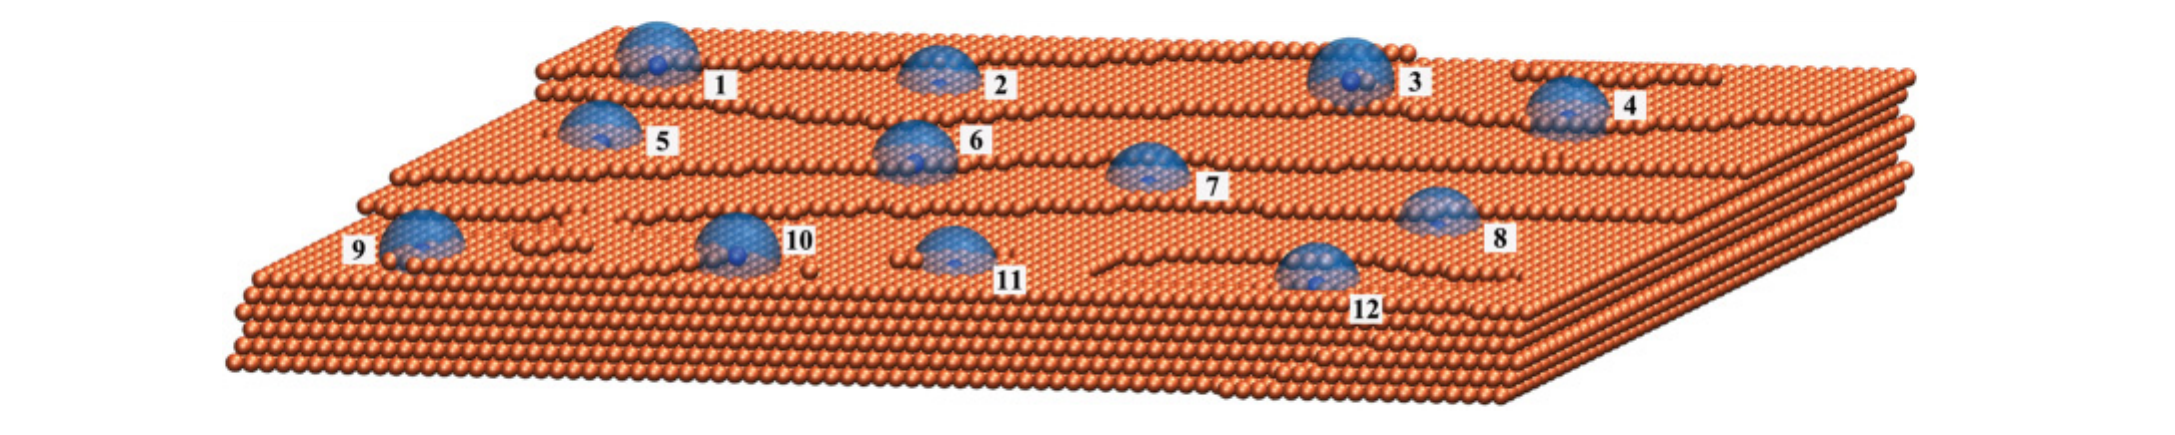
图 10:带有空位、吸附原子、台阶和扭折等多种缺陷的“真实”铜表面。十二个代表性原子的原子环境以蓝色球体标出,由对称函数的截断半径定义。相应的团簇见图 11。
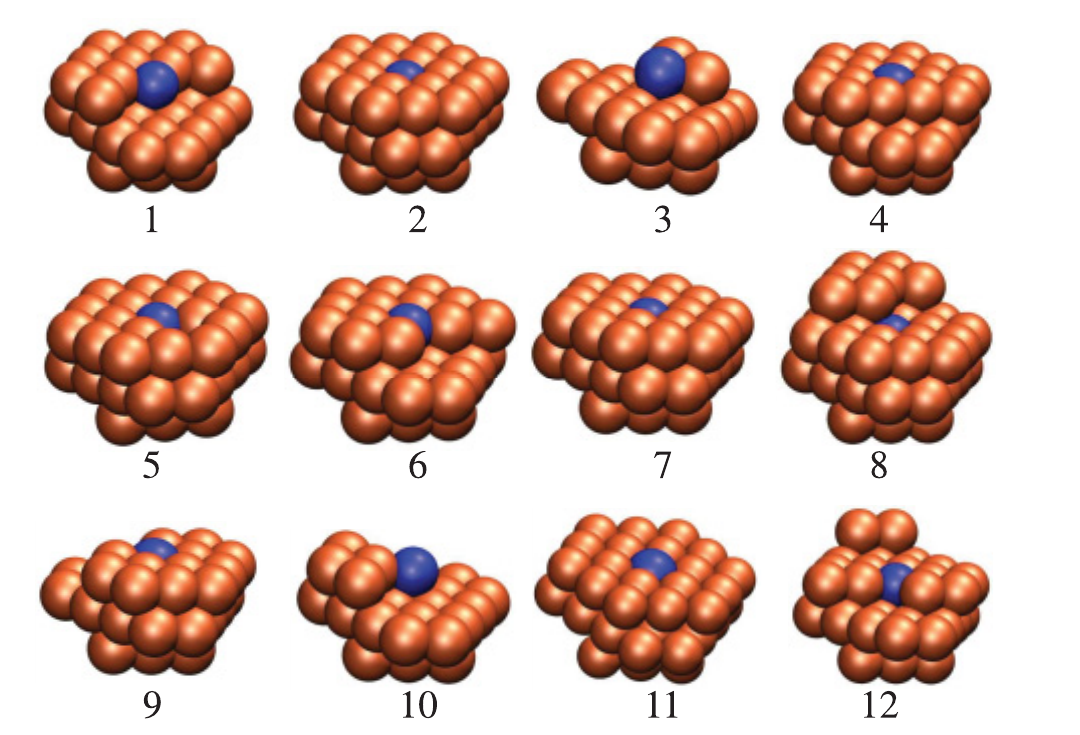
图 11:用 6 Å 截断半径从图 10 的表面中截取的十二个团簇。作用在蓝色中心原子上的力可用来估计 NN 势对扩展体系的精度,比较见图 12。
图 12 比较了这十二个团簇中心原子的受力:定性吻合很好,但定量上有一些差异。分析发现,力依赖的化学环境比原子能量更大。这乍看奇怪,实则是能量–位置函数关系的必然结果:原子 $i$ 沿 $\alpha = {x, y, z}$ 方向的力是总能量对 $R_{i,\alpha}$ 的导数,而总能量是所有原子能量之和,
$$ F_{i,\alpha} = -\frac{\partial}{\partial R_{i,\alpha}} E = -\frac{\partial}{\partial R_{i,\alpha}} \sum_j E_j. \tag{11} $$
所有把原子 $i$ 包含在其截断球内的原子 $j$ 的能量导数都进入 $F_{i,\alpha}$,因此力依赖以 $i$ 为中心、半径 $2R_c$ 的球内所有原子。半径 6 Å 的团簇不足以在中心原子处给出收敛的 NN 力,也不能代表扩展表面的原子环境。
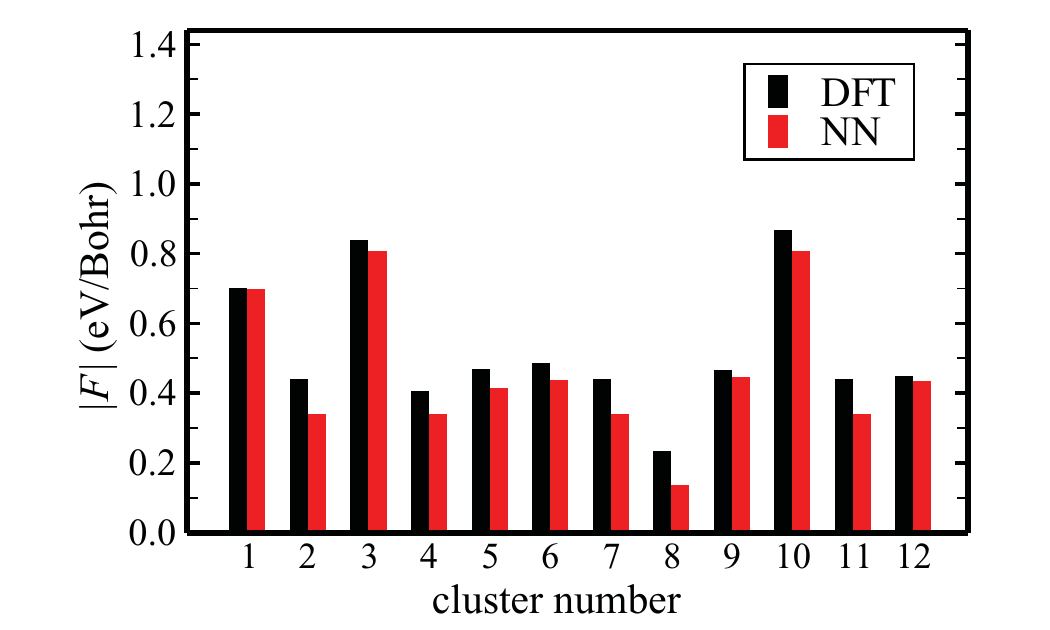
图 12:图 11 所示十二个团簇(含中心原子周围 6 Å 内所有原子)中心原子所受 DFT 与 NN 力的比较。
作者用半径 12 Å 的团簇验证了这一点(图 13):一致性明显改善。距中心原子超过 12 Å 的原子不进入 $F_{i,\alpha}$,所以 12 Å 团簇的 NN 力与整个平板中的 NN 力完全相同——这就用小的子体系证明了 NN 能精确描述大体系的 PES。残留差异来自拟合本身的不精确(这些团簇不在训练集中),把它们加入训练集即可减小偏差;这为改进整体上无法用 DFT 处理的大体系的 NN 势提供了系统途径。
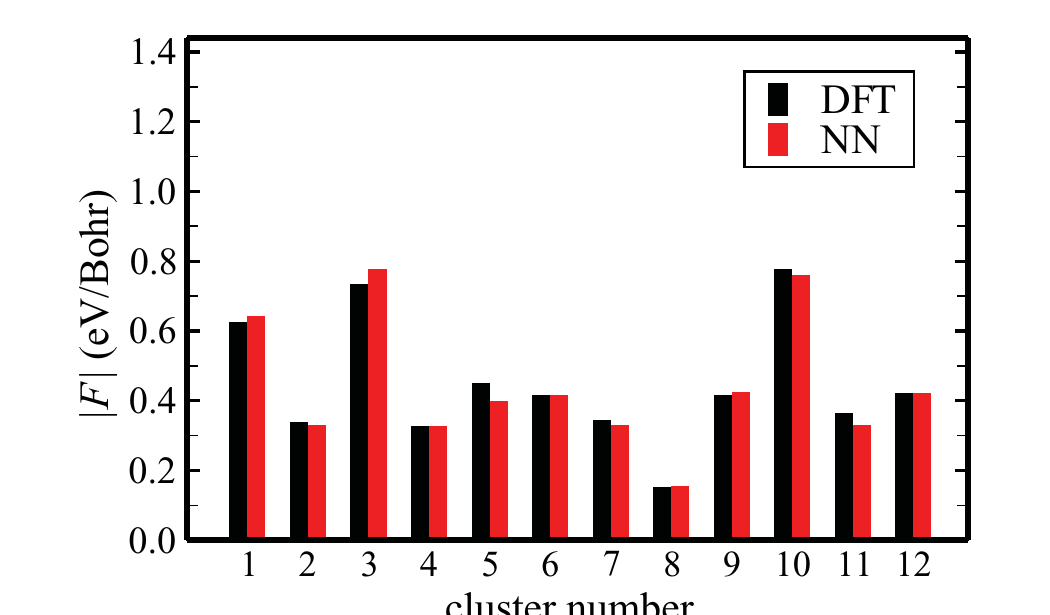
图 13:以 12 Å 半径从图 10 的平板中截取的 12 个团簇中心原子所受 DFT 与 NN 力的比较。
最后作者强调:尽管能量和力的有效依赖范围不同,总能量与力仍完全自洽,因为力是式 (2)、(3) 的精确解析导数。这种范围差异只在截断半径很小时才重要;本例中 6 Å 与 12 Å 团簇的中心原子受力并无实质差别。它主要影响检验势品质的方式,对构建势本身无关紧要——训练集本来就包含大量足够大的周期性和非周期性结构。铜 PES 的优异品质表明 6 Å 截断对该体系合适,更大的截断只能带来微小改进。
优点与局限
**优点。**函数形式中没有体系特定项,为新体系构建势时无需调整函数形式——哪怕体系差异大到金属与小共价分子之别;对各类相互作用无偏;足够灵活以精确适应电子结构参考数据,且不需要任何关于底层函数形式的知识。
**代价。**高灵活性意味着需要大量训练点(高维 PES 通常数万个)才能保证 PES 形状正确,因此只有在做长时间 MD/蒙特卡洛模拟或研究对 DFT 而言过大的体系时,构建 NN 势的投入才划算。NN 函数形式和对称函数变换的求值代价高于简单经验势,所以 NN 势效率不如经验势,但仍比 DFT 快好几个数量级;由于每个原子一个 NN,NN 势随体系大小线性标度,加速比取决于体系大小。
**外推风险。**NN 势只在训练集覆盖的结构范围内有效——只用体相铜训练的势用于表面必然失效。好在外推很容易检测:有效范围由训练集中每个对称函数的最小值和最大值给出,对新结构算出对称函数后与该范围比较,只要有一个函数越界,预测就可能不可靠。这一检验还能用来系统搜索外推结构、扩展势的有效范围。即使没有外推,训练集代表性不足的区域预测也可能不准,此时可用前述多拟合比较法识别;发现问题构型后只需向训练集添加结构,无需改变函数形式。
**元素数量限制。**当前方案只能处理少数几种元素,因为多组分体系所需的对称函数数目迅速增长;最适合至多三到四种元素、但每种元素原子数可以很多的体系。二元体系氧化锌的初步结果已发表 \cite{artrith2011zno},更多体系的工作正在进行。
结论
作者以铜为模型体系考察了高维 NN 势对金属表面的适用性。利用约 38 000 个 DFT 参考计算构建的 NN 势能够非常精确地复现这些结构的能量和力,对训练集之外的结构也能可靠预测,出现较大偏差时还可系统改进。fcc 铜及其他晶体结构的结构与能量性质、空位等缺陷、有限温度 MD 中出现的结构都与 DFT 吻合极佳。通过表面能、空位形成能和扩散铜原子的势验证了对表面的适用性,并证明 DFT 无法处理的、带多种缺陷的超大表面结构同样可以被可靠描述。因此,NN 为研究带各种缺陷的大型"真实"金属表面提供了一条构建精确高效势的有前景途径;由于函数形式不含体系特定项,它原则上能以同样精度描述截然不同的原子相互作用,为腐蚀、自组装单层形成等表面化学过程的势函数构建提供了起点。
致谢
原作者感谢 DFG(Emmy Noether 计划、SFB 558)、Fonds der Chemischen Industrie 和北莱茵–威斯特法伦州科学院的资助,感谢与 FHI-aims 团队、Karsten Reuter、Ralf Gehrke 和 Björn Hiller 的讨论,以及 LiDOng 集群提供的计算时间。